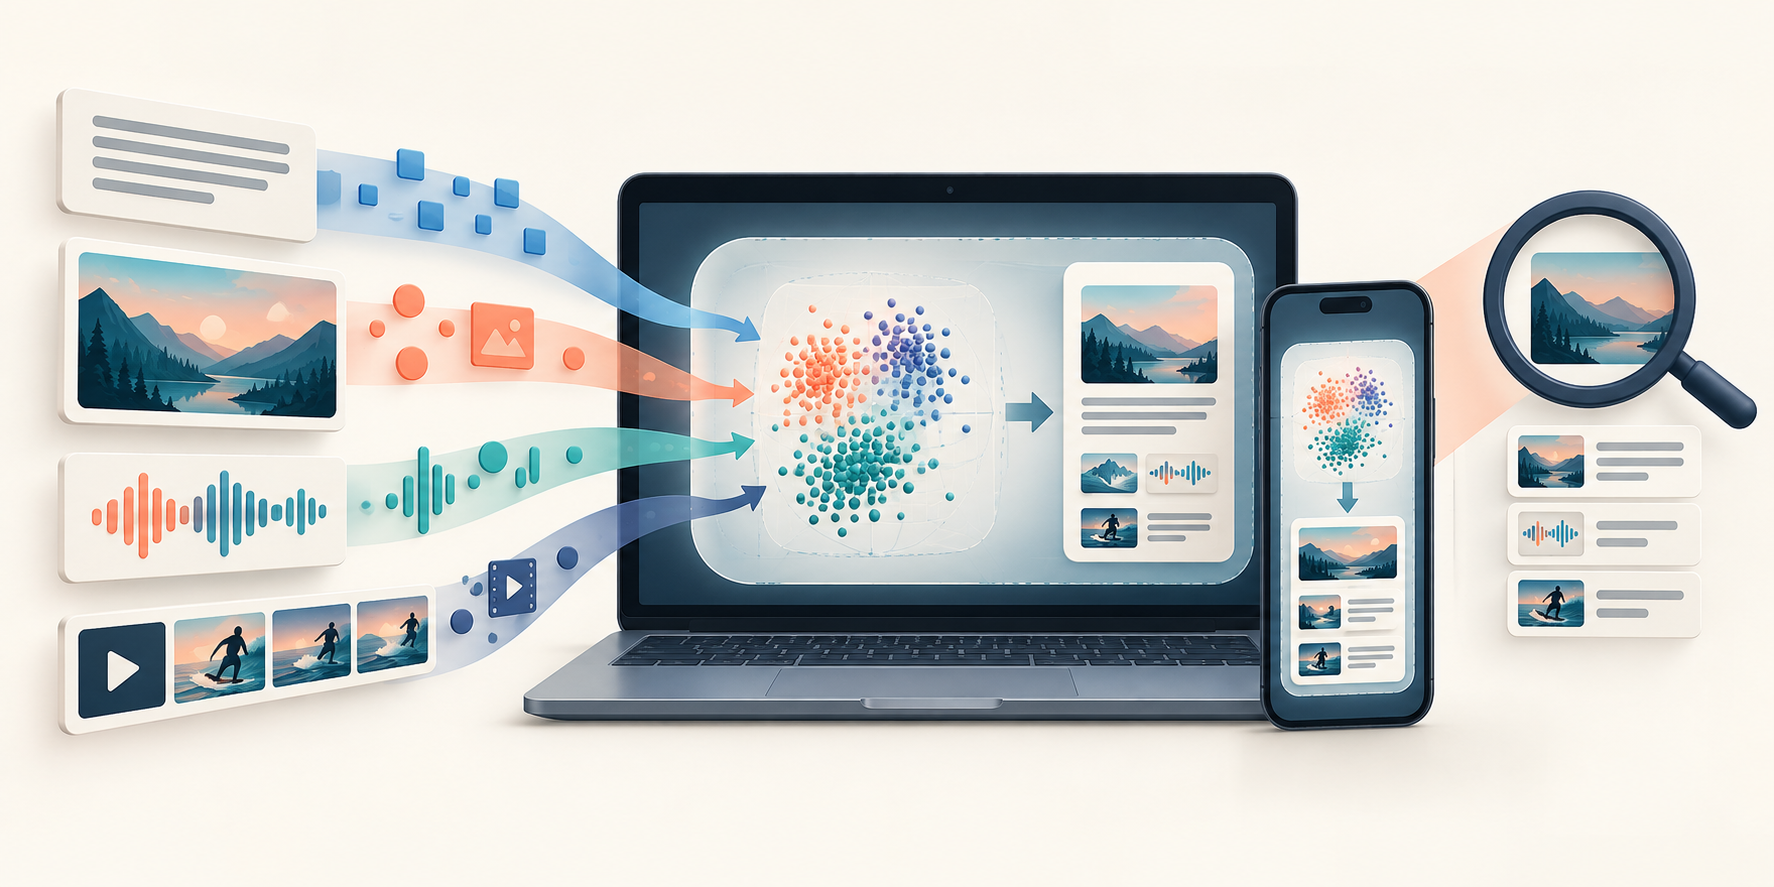
2026 年 10 月 6 日,Google DeepMind 发布 EmbeddingGemma 2,将文本(含代码)、图像、音频和视频映射到同一个向量空间,面向手机与笔记本上的语义搜索和检索增强生成(RAG)。官方公告与模型卡均标注 Apache 2.0 许可证。
可以用来做什么?
嵌入模型将内容转换成可比较的数字表示,用于寻找语义相近的资料。它本身不生成聊天回答;在 RAG 应用中,可先检索资料,再交由生成模型组织答案。Google 同日更新 AI Edge Gallery 的本地媒体检索示例,展示文字或图片查找媒体,以及定位视频片段的流程。
按需加载,控制体积
完整模型为 7.4 亿参数,其中文本模块 2.7 亿、视觉编码器 1.7 亿、音频编码器 3 亿。开发者可以仅加载需要的模态。原生向量维度为 768,也支持 512、256、128 维截断;向量更短可节省存储,但应检查检索质量。模型卡提示,截断后需重新归一化,查询与资料库的向量维度必须一致。
上手入口与限制
官方提供模型下载、SentenceTransformers 示例以及 MediaPipe、LiteRT 等端侧部署路径。AI Edge 团队说明,面向 Android 的 ML Kit 服务将在未来数周提供,不能视为已全面上线。实际资源占用取决于设备、精度与所加载模块,端侧运行也需要先准备模型与索引。
模型卡提醒,不同语言的表现可能不同;文本检索应使用对应任务前缀,并以自己的资料测试效果。本站观察:这类工具可用于个人媒体库、代码库和内部知识库搜索,选型时应重点检查相关结果能否准确召回,以及索引维护成本。以上为基于官方资料的应用分析,本站未做设备性能测试。
原始来源
核对日期:2026 年 10 月 7 日。
© 版权声明
文章版权归作者所有,未经允许请勿转载。